


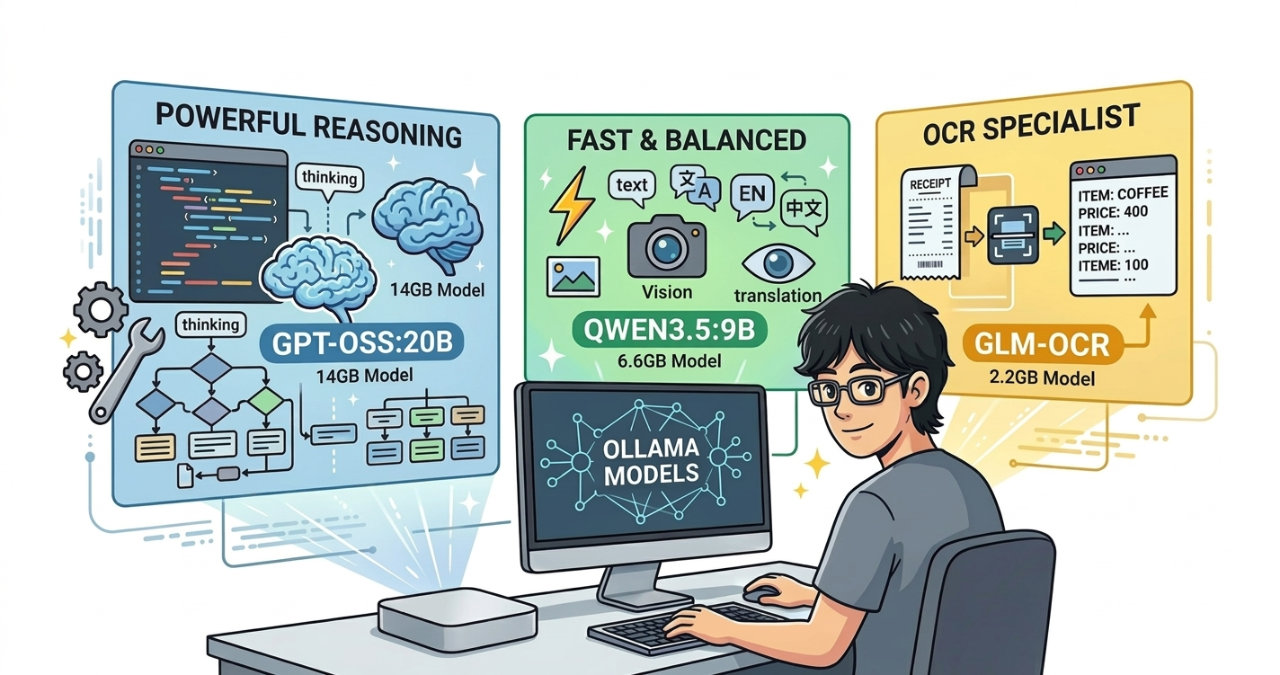
ローカルLLM を触っていると、必ず出てくるのが「どのモデルを使えばいいのか」という問題です。
ネット上にはおすすめモデルの情報も多いですが、
- 環境によって変わる
- 用途によって変わる
- 実際に使うと印象が変わる
というのが正直なところです。
この記事では、「一般的なおすすめ」ではなく、
- Mac mini M4( 32GB メモリ / 1TB SSD )
- Ollama 0.35.0
という環境で、実際に試して今も使っているモデルをまとめます。
いわゆるランキングではなく、「実験ログ」に近い形です。
これからモデルを選ぶときの参考になればと思います。
使っている環境
今回の検証環境は以下です。
| CPU | Apple M4 |
| メモリ | 32GB |
| ストレージ | 1TB SSD |
| OS | macOS Tahoe 26.3.1(記事作成時点) macOS Tahoe 26.6.2(記事更新時点) |
| Ollama | 0.19.0(記事作成時点) 0.35.0(記事更新時点) |
この構成であれば、20B 〜 35B クラスのモデルも現実的に動かせます。
ただし重要なのは、「動くかどうか」ではなく、
- 快適に使えるか
- 他の作業と両立できるか
という点です。
ローカルLLM はメモリを大きく消費するため、常に余裕を意識する必要があります。
モデル選びの前提
最初に結論っぽい話をしておくと、モデルは1つに絞らない方がいいです。
用途によって向き不向きがあるため、
- 重いけど精度が高いモデル
- 軽くてすぐ試せるモデル
- 特化型モデル
という形で分けた方が使いやすくなります。
この前提で、僕は現在いくつかのモデルを使い分けています。
実際に使っているモデル
ここからは、実際に触って「気に入っているモデル」だけを紹介します。
- 2026年10月
- 2026年8月
- 2026年7月
- 2026年6月
- 2026年4月
| モデル | モデルサイズ | 用途 |
|---|---|---|
| gpt-oss:20b | 約14GB | OCR・JSON 整形 |
| gemma4:26b | 約18GB | 日常チャット・記事作成・WordPress 自動化 |
| PaddleOCR-VL-1.5 | 約2.2GB | OCR |
| ornith-1.5:35b | 約22GB | ChatGPT Work + Ego Browser( AI によるブラウザ操作)や コーディング |
| モデル | モデルサイズ | 用途 |
|---|---|---|
| gpt-oss:20b | 約14GB | OCR・JSON 整形 |
| gemma4:26b | 約18GB | 日常チャット・記事作成・WordPress 自動化 |
| glm-ocr | 約2.2GB | OCR |
| ornith-1.5:35b | 約22GB | ChatGPT Work + Ego Browser( AI によるブラウザ操作)Claude Code・Hermes Agent |
| モデル | モデルサイズ | 用途 |
|---|---|---|
| gpt-oss:20b | 約14GB | OCR・JSON 整形 |
| gemma4:26b | 約18GB | 日常チャット・記事作成・WordPress 自動化 |
| glm-ocr | 約2.2GB | OCR |
| qwen3.6:35b-a3b-nvfp4 | 約21GB | Claude Code・Hermes Agent |
| ornith:35b | 約21GB | ChatGPT Work + Ego Browser( AI によるブラウザ操作) |
| モデル | モデルサイズ | 用途 |
|---|---|---|
| gpt-oss:20b | 約14GB | OCR・JSON 整形 |
| gemma4:26b | 約18GB | 日常チャット・記事作成・WordPress 自動化 |
| glm-ocr | 約2.2GB | OCR |
| qwen3.6:35b-a3b-nvfp4 | 約21GB | Claude Code・Hermes Agent |
| モデル | モデルサイズ | 用途 |
|---|---|---|
| gpt-oss:20b | 約14GB | OCR・JSON 整形 |
| qwen3.5:9b | 約6.6GB | 日常チャット |
| glm-ocr | 約2.2GB | OCR |
| qwen3.5:35b-a3b-coding-nvfp4 | 約22GB | Claude Code・Hermes Agent |
gpt-oss:20b
gpt-oss:20b は、OpenAI が公開したオープンウェイトモデルです。
ローカル環境での利用を前提に設計されており、推論性能と実用性のバランスに優れています。
Ollama では 約14GB で利用でき、ツール呼び出し(Function Calling)や構造化出力(Structured Outputs)、推論(Reasoning)に対応しています。
そのため、チャットだけでなく AI エージェントや自動化処理など、幅広い用途で活用できるモデルです。
公式では 16GB メモリの PC でも動作可能とされていますが、実際には OS やブラウザなど他のアプリもメモリを使用します。
快適に利用するには、32GB 以上のメモリを搭載した環境があると安心です。

OCR で読み取ったレシートを JSON へ整形したり、家計簿へ仕訳したりする処理で今も活躍しています。回答も安定しているので、自動化処理で安心して使えるモデルです。
ただ、gemma4 登場以来、gpt-oss:20b の出番は少なめかも。
gemma4:26b
Gemma 4 は、Google DeepMind が開発する オープンソースLLM です。
テキストだけでなく画像入力にも対応しており、推論やコーディング、エージェント用途など幅広いタスクで利用できます。
gemma4:26b は 約18GB の MoE(Mixture of Experts)モデルです。
モデルサイズの割に軽快に動作し、応答速度と性能のバランスに優れています。
日本語の品質も高く、ローカル環境で日常的に利用しやすいモデルです。
WordPress の記事作成や自動化でメインに使っているモデルです。日本語がとても自然で安定しているので気に入っています。31B の Dense モデルも試しましたが、僕の環境では重かったため、現在は 26B の MoE モデルを使っています。こちらも非検閲モデルも利用しています。
ornith-1.5:35b
Ornith-1.5 は、Ornith( Ornith 1.0 )の後継となるエージェント型モデルです。
従来の Ornith 1.0 では、エージェントがタスクを実行するための仕組みや、実際の作業結果を改善することに重点が置かれていました。
Ornith-1.5 では、そこからさらに一歩進み、
- タスクそのものを生成する
- タスクを解くための方法を考える
- 実際に解決して結果を評価する
という自己改善のループを、より広い範囲で最適化するように設計されています。
Ollama では 9B、35B、397B が公開されており、35B は 約23GB( Ollama で実際にモデルをダウンロードすると 22GB と表示されました)。
256K のコンテキスト長と画像入力にも対応しています。
僕が使っているのは 35B です。
これまで使っていた Ornith 1.0 から置き換えて、現在はこちらを使っています。
Mac mini M4(32GB)でも問題なく動作していますし、Ego Browser も良い感じに動いています。
2026年7月ごろまでは Hermes Agent や Claude Code 用に qwen3.6:35b-a3b-nvfp4 を使っていましたが、エージェントツールは ornith-1.5:35b に入れ替えてみてもいいかなと思いました。
このまま固定して使い続けるか、将来的には戻すのか、別のモデルに置き換えるのか、また更新した時のお楽しみです。
PaddleOCR-VL-1.5
PaddleOCR-VL-1.5 は、PaddlePaddle が開発するドキュメント解析向けの軽量なマルチモーダルモデルです。
0.9B(9億)パラメータと比較的小さなモデルながら、通常の文字認識だけでなく、
- 表(テーブル)
- 数式
- グラフ・図表
- テキストの位置検出
- 印章(スタンプ)の認識
など、さまざまなドキュメント解析に対応しています。
また、スキャン画像や傾いた書類、歪んだ画像、スマートフォンなどで撮影した書類といった、実際の利用環境で発生しやすい条件にも対応しています。
PaddleOCR-VL-1.5 は 0.9B という比較的小さなモデルなので、OCR 用途で利用するモデルとして扱いやすいのも特徴です。
僕はこれまで、レシートOCR には glm-ocr を使っていました。
ところが、Ollama を v0.34.1 以降にアップデートしてから、僕の環境では glm-ocr が正常に動作しなくなりました。
そのため、現在はレシートOCR の自動化処理を PaddleOCR-VL-1.5 に切り替えています(GGUF モデルを Ollama で動かしています)。
実際のところ、モデルそのものの性能だけでなく、「今の環境で安定して動くか」という点も、ローカルLLM ではかなり重要だと感じています。
今後は PaddleOCR-VL-1.5 を使って、レシート画像からの文字読み取りやデータ化など、これまで glm-ocr で行っていた OCR の自動化処理を試していく予定です。
※ PaddleOCR-VL-1.5 は Hugging Face で公開されているモデルです。2026年3月から llama.cpp による VLM コンポーネントの推論にも対応しています。
qwen3.5:9b
qwen3.5:9b は、Alibaba が開発する Qwen シリーズのモデルです。
Ollama では 約6.6GB で利用でき、比較的軽量なモデルのため、ローカルLLM を初めて試す人でも導入しやすいサイズとなっています。
Vision・Tools・Thinking に対応しており、文章作成から画像の内容理解、エージェント用途まで幅広く利用できます。
モデルサイズに対して性能のバランスが良く、応答速度も速いため、「まず最初に試す1つ」として選びやすいモデルです。
また、日本語でのやり取りも比較的自然で、日常的なチャットや簡単なコード生成など、幅広い用途で扱いやすい印象があります。
qwen は中国語の文字が混ざることが割と多い印象があり、文章作成にはあまり使っていません。ただ、チャット用途では応答が速く軽快なので、今でも使いやすいモデルだと思っています。
現在は通常版はアンインストールし、qwen3.5:9b の非検閲モデルだけを残しています。普段は gemma4 をメインに使っているため、qwen は必要なときに使うようにしています。
glm-ocr
glm-ocr は、画像内の文字を高精度で読み取ることに特化したマルチモーダル OCR モデルです。
Ollama では 約2.2GB で利用でき、画像とテキストを入力として扱えます。
一般的な OCR だけでなく、表(テーブル)や数式、図表を含む複雑なドキュメントの認識にも対応しています。
軽量なモデルながら、帳票やレシート、請求書など実務で扱う文書の読み取りにも適しており、OCR 用途でローカル環境を構築したい場合に導入しやすいモデルです。
レシート OCR 用として使っています。モデルサイズが 約2.2GB と軽量なので、気軽に使えるのも魅力です。半角カナは読み取れないので、その点は割り切って使っていますが、それ以外はかなり精度が高く、ローカルで OCR を完結できるのが気に入っています。
💡 もっと詳しく知りたい方へ
glm-ocrを使ったレシート OCR の検証結果は、別記事で詳しくまとめています。
- OCR の読み取り精度
- n8n との連携方法
- JSON スキーマやプロンプト改善のポイント
- 家計簿自動化までの流れ
など、実際に試した内容を画像付きで紹介しています。
➡️ glm-ocr とは?ローカルLLM で OCR は実用になるのか検証してみた(Ollama × n8n)

qwen3.6:35b-a3b-nvfp4
Qwen3.6-35B-A3B をベースに、NVIDIA がNVFP4 形式へ量子化したモデルです。
MoE(Mixture of Experts)アーキテクチャを採用しており、必要なパラメータだけを有効化して推論するため、35B クラスながら比較的軽快に動作します。
Ollama 版は 約22GB で、僕の Mac mini M4(メモリ32GB)でも快適に利用できています。
チャットやコーディング、エージェント用途など幅広く利用できる、バランスの良いモデルです。
Claude Code や Hermes Agent などのエージェントツールで使っています。応答速度が速く、コード生成も安定しています。中国語が混ざることがありますが、それ以外は使いやすいモデルです。
以前は qwen3.5:35b-a3b-coding-nvfp4 を使っていましたが、qwen3.6:35b-a3b-nvfp4 にモデルチェンジしました。
ornith:35b
Ornith は、エージェント型コーディングに特化して学習された オープンソースLLM です。
35B モデルは 約21GB で、Qwen3.5 系の MoE アーキテクチャをベースにしており、コード生成だけでなくツール呼び出しや複数ステップのタスク実行にも強みがあります。
一般的なチャット用途というよりも、「AI に何かを操作させる」ようなエージェント用途で真価を発揮するモデルです。
僕の環境では Mac mini M4(32GB)でも問題なく動作しており、Chat GPT Work(旧 Codex App)と組み合わせて利用しています。
特に、Ego Browser を使ったブラウザ操作では非常に安定しており、
- Webサイトを開く
- 情報を収集する
- 内容を要約する
といった一連の作業を最後まで完了できることが多くなりました。
使い分けの考え方
今のところ、僕の中ではこんな感じで使い分けています。
gpt-oss:20b
→ レシート OCR の JSON 整形(既存の n8n ワークフロー)でそのまま使ってます。
PaddleOCR-VL-1.5-GGUF
→ レシート OCR や画像からの文字起こし、自動化処理で利用しています。
gemma4:26b
→ 日常チャットから長めの文章を書くとき等、多岐にわたって利用しています。
ornith:35b
→ AI によるブラウザ操作やコーディング(ChatGPT Work などのエージェントツール使用時)に使っています。
重要なのは、最適な1つを探すことではなく、用途ごとに分けることです。
Ollama はモデルの切り替えが簡単なので、
- 試す
- 合わなければ変える
を前提にした方がうまくいきます。
まとめ
Mac mini M4(32GB)環境で、現在よく使っているモデルは以下の通りです。
- gemma4:26b
- ornith:35b
- gpt-oss:20b
- PaddleOCR-VL-1.5-GGUF
この構成にしてから、
- 重すぎて使えない
- 軽いけど精度が足りない
といったストレスはかなり減りました。
ローカルLLM は、
- モデル選び
- メモリ管理
- 使い分け
で体験が大きく変わります。
最初から正解を探すよりも、いくつか試して残すというやり方の方が、結果的に早いです。
今後も、Ollama のアップデートや新モデルに合わせて、このあたりは随時見直していきます。

